strDesde: siempre
Una secuencia de puntos de código Unicode.
Podés iterar sobre los grupos de grafemas de la cadena con un bucle for. Los grupos de grafemas son básicamente caracteres, pero mantienen juntas las cosas que van juntas, por ejemplo, varios puntos de código que en conjunto forman un emoji de bandera. Las cadenas de texto se pueden sumar con el operador +, unir y multiplicar por enteros.
Typst ofrece métodos de utilidad para manipular cadenas de texto. Muchos de estos métodos (por ejemplo, split, trim y replace) operan sobre patrones: un patrón puede ser una cadena de texto o una expresión regular. Esto hace que los métodos sean muy versátiles.
Todas las longitudes e índices se expresan en bytes UTF-8. Los índices empiezan en cero y los índices negativos dan la vuelta hasta el final de la cadena.
Podés convertir un valor en cadena de texto con el constructor str.
Ejemplo
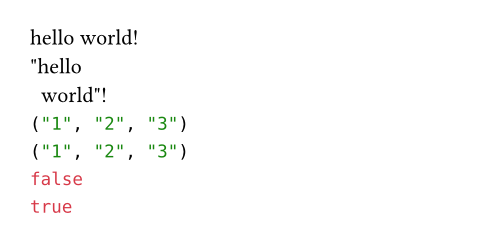
#"hello world!" \
#"\"hello\n world\"!" \
#"1 2 3".split() \
#"1,2;3".split(regex("[,;]")) \
#(regex("\\d+") in "ten euros") \
#(regex("\\d+") in "10 euros")
Secuencias de escape
Igual que en el marcado, en las cadenas de texto podés escapar algunos símbolos:
\\para una barra invertida\"para una comilla\npara un salto de línea\rpara un retorno de carro\tpara una tabulación\u{1f600}para una secuencia de escape Unicode hexadecimal
Constructor
Convierte un valor en una cadena de texto.
- Los enteros se formatean en base 10. Esto se puede cambiar con el parámetro opcional
base. - Los flotantes se formatean en base 10 y nunca en notación exponencial.
- Los enteros y flotantes negativos se formatean con el signo menos de Unicode (“−” U+2212) en lugar del signo menos ASCII (“-” U+002D).
- De las etiquetas se extrae el nombre.
- Los bytes se decodifican como UTF-8.
Si querés convertir desde y hacia puntos de código Unicode, mirá las funciones to-unicode y from-unicode.
 Ver ejemplo
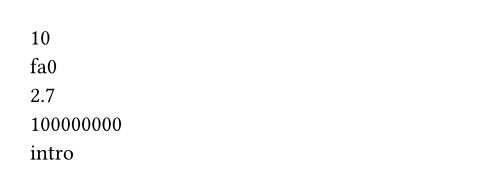
#str(10) \
#str(4000, base: 16) \
#str(2.7) \
#str(1e8) \
#str(<intro>)
value
El valor que se debe convertir en cadena de texto.
basePor defecto: 10
La base (raíz) en la que se muestran los enteros, entre 2 y 36.
Funciones
lenDesde: siempre
La longitud de la cadena en bytes codificados en UTF-8.
firstDesde: siempre
Extrae el primer grupo de grafemas de la cadena.
Devuelve el valor por defecto indicado si la cadena está vacía, o falla con un error si no se especificó ningún valor por defecto.
default
Un valor por defecto para devolver si la cadena está vacía.
lastDesde: siempre
Extrae el último grupo de grafemas de la cadena.
Devuelve el valor por defecto indicado si la cadena está vacía, o falla con un error si no se especificó ningún valor por defecto.
default
Un valor por defecto para devolver si la cadena está vacía.
atDesde: siempre
Extrae el primer grupo de grafemas después del índice especificado. Devuelve el valor por defecto si el índice está fuera de rango, o falla con un error si no se especificó ningún valor por defecto.
index
El índice de bytes. Si es negativo, se indexa desde el final.
defaultany
Un valor por defecto para devolver si el índice está fuera de rango.
sliceDesde: siempre
Extrae una subcadena de la cadena. Falla con un error si el índice de inicio o de fin está fuera de rango.
start
El índice de bytes inicial (inclusivo). Si es negativo, se indexa desde el final.
endPor defecto: none
El índice de bytes final (exclusivo). Si se omite, se extrae toda la porción hasta el final de la cadena. Si es negativo, se indexa desde el final.
count
La cantidad de bytes que se extraen. Equivale a pasar start + count como posición end. Es mutuamente excluyente con end.
clustersDesde: siempre
Devuelve los grupos de grafemas de la cadena como un array de subcadenas.
codepointsDesde: siempre
Devuelve los puntos de código Unicode de la cadena como un array de subcadenas.
to-unicodeDesde: 0.5.0
Convierte un carácter en su punto de código correspondiente.
Ver ejemplo
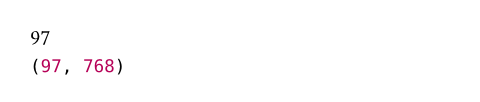
#"a".to-unicode() \
#("a\u{0300}"
.codepoints()
.map(str.to-unicode))
character
El carácter que se debe convertir.
from-unicodeDesde: 0.5.0
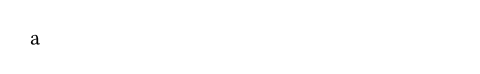
Convierte un punto de código Unicode en su cadena correspondiente.
Ver ejemplo
#str.from-unicode(97)
value
El punto de código que se debe convertir.
normalizeDesde: 0.14.0
Normaliza la cadena a la forma normal Unicode indicada.
Esto es útil al manipular cadenas que contienen caracteres combinados de Unicode.
#assert.eq("é".normalize(form: "nfd"), "e\u{0301}")
#assert.eq("ſ́".normalize(form: "nfkc"), "ś")formPor defecto: "nfc"
| Variante | Detalles |
|---|---|
"nfc" | Composición canónica, en la que, por ejemplo, las letras acentuadas se convierten en un único punto de código Unicode. |
"nfd" | Descomposición canónica, en la que, por ejemplo, las letras acentuadas se dividen en una base y un signo diacrítico separados. |
"nfkc" | Como NFC, pero usando las descomposiciones de compatibilidad de Unicode. |
"nfkd" | Como NFD, pero usando las descomposiciones de compatibilidad de Unicode. |
containsDesde: siempre
Si la cadena contiene el patrón especificado.
Este método también tiene una sintaxis dedicada: podés escribir "bc" in "abcd" en lugar de "abcd".contains("bc").
pattern
El patrón que se busca.
starts-withDesde: siempre
Si la cadena empieza con el patrón especificado.
pattern
El patrón con el que podría empezar la cadena.
ends-withDesde: siempre
Si la cadena termina con el patrón especificado.
pattern
El patrón con el que podría terminar la cadena.
findDesde: siempre
Busca el patrón especificado en la cadena y devuelve la primera coincidencia como cadena de texto, o none si no hay ninguna.
pattern
El patrón que se busca.
positionDesde: siempre
Busca el patrón especificado en la cadena y devuelve el índice de la primera coincidencia como entero, o none si no hay ninguna.
pattern
El patrón que se busca.
matchDesde: siempre
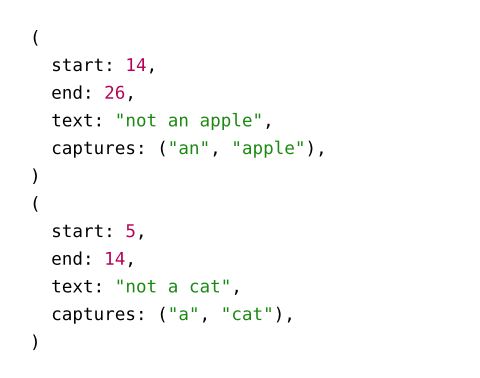
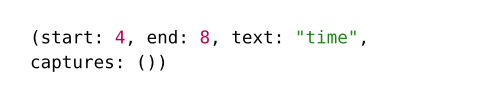
Busca el patrón especificado en la cadena y devuelve un diccionario con detalles sobre la primera coincidencia, o none si no hay ninguna.
El diccionario devuelto tiene las siguientes claves:
start: El desplazamiento de inicio de la coincidenciaend: El desplazamiento de fin de la coincidenciatext: El texto que coincidió.captures: Un array con una cadena de texto por cada grupo de captura que coincidió. ¡El primer elemento del array contiene la primera captura, no la coincidencia completa! Está vacío, salvo que elpatternsea una regex con grupos de captura.
Ver ejemplo: Forma del diccionario devuelto
#let pat = regex("not (a|an) (apple|cat)")
#"I'm a doctor, not an apple.".match(pat) \
#"I am not a cat!".match(pat)
Ver ejemplo: Distintos tipos de patrones
#assert.eq("Is there a".match("for this?"), none)
#"The time of my life.".match(regex("[mit]+e"))
pattern
El patrón que se busca.
matchesDesde: siempre
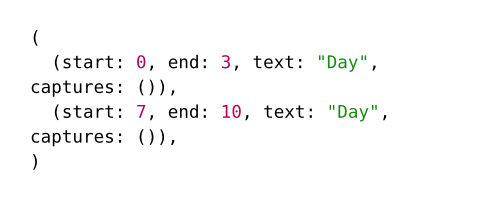
Busca el patrón especificado en la cadena y devuelve un array de diccionarios con detalles sobre todas las coincidencias. Para más detalles sobre los diccionarios devueltos, mirá arriba.
Ver ejemplo
#"Day by Day.".matches("Day")
pattern
El patrón que se busca.
replaceDesde: siempre
Reemplaza como máximo count apariciones del patrón indicado por una cadena o función de reemplazo (empezando desde el principio). Si no se indica una cantidad, se reemplazan todas las apariciones.
pattern
El patrón que se busca.
replacement
La cadena por la que se reemplazan las coincidencias, o una función que recibe un diccionario por cada coincidencia y puede devolver cadenas de reemplazo individuales.
El diccionario que se le pasa a la función tiene la misma forma que el diccionario devuelto por match.
count
Si se indica, solo se reemplazan las primeras count coincidencias del patrón.
trimDesde: siempre
Elimina las coincidencias de un patrón de uno o ambos lados de la cadena, una vez o repetidamente, y devuelve la cadena resultante.
patternPor defecto: none
El patrón que se busca. Si es none, recorta los espacios en blanco.
at
Puede ser start o end para recortar solo el inicio o el final de la cadena. Si se omite, se recortan ambos lados.
repeatPor defecto: true
Si se eliminan repetidamente las coincidencias del patrón o solo una vez. Por defecto es true.
splitDesde: siempre
Divide una cadena en las coincidencias de un patrón especificado y devuelve un array con las partes resultantes.
Cuando se usa la cadena vacía como separador, se separa cada carácter (es decir, cada punto de código Unicode) de la cadena, junto con el principio y el final. En la práctica, esto significa que la lista de partes resultante contendrá la cadena vacía al principio y al final.
patternPor defecto: none
El patrón por el que se divide. Por defecto son los espacios en blanco.
revDesde: 0.8.0
Invierte la cadena.
Más específicamente, devuelve una cadena con los mismos grupos de grafemas, en orden inverso.
Ver ejemplo
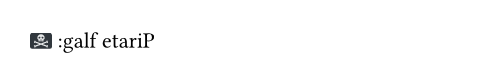
#"Pirate flag: 🏴☠️".rev()